上汽集团日前对外宣布,将与XHEART(新芯航途)围绕700 TOPS大模型算力芯片开展模型适配与整车应用协同,把芯片纸面算力转化为用户可感知的智驾体验。按照双方规划,合作不止于当下这一颗芯片,下一步将共同瞄准数千TOPS级大模型算力平台,为L3、L4级自动驾驶的规模化装车准备计算底座。
不同于过去“模型去适配已有芯片”的做法,这次合作提出“大模型定义芯片”的技术路径:先从实际驾驶任务出发确定能力目标,再反向推导模型对计算能力的需求,最后由芯片架构与软件协同实现。围绕这一思路,上汽将推进算子融合、并行执行与任务调度优化,同步调整总线架构与片上缓存设计,保障关键计算任务的数据带宽,并前瞻布局LPDDR6等新一代内存技术,联合生态伙伴推动4bit量化在大参数智驾模型上的量产落地。
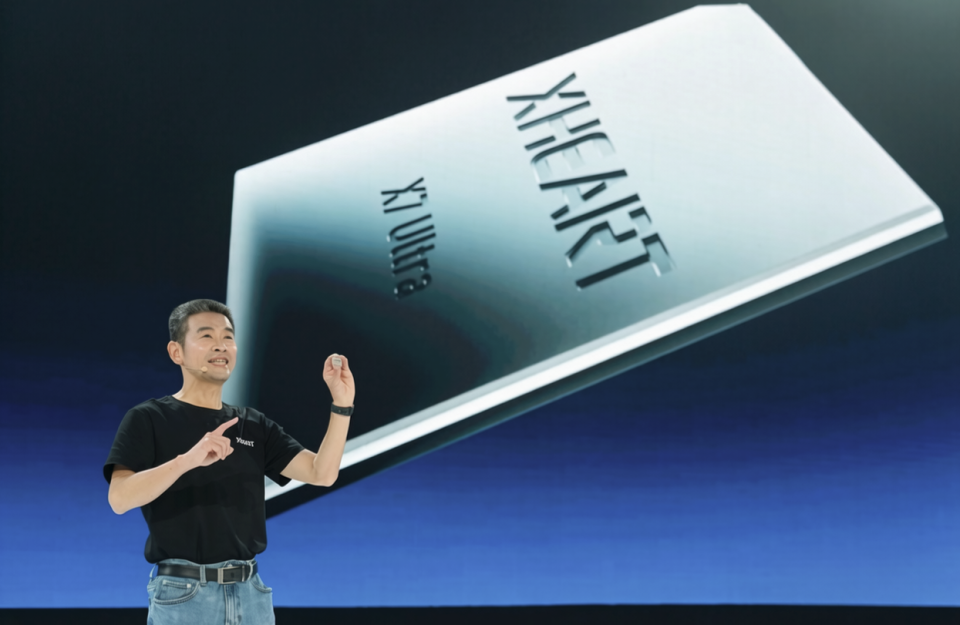
芯片底座来自XHEART今年10月29日在苏州发布、面向量产的大模型智驾芯片X7 Ultra。该芯片大模型算力达700 TOPS,据XHEART CEO李宗霖介绍,这一数字基于真实量产智驾大模型评测,并以量化部署后模型输出与训练后FP32浮点模型相似度达到99.99%以上为约束测得。硬件上采用超大核NPU,把传统小核之间百GB/s级的数据交互聚合到核内TB/s级高速互联;基于量产模型实测NPU计算利用率98.7%,内存带宽消耗下降80%、能效提升100%,可部署模型参数量提升10倍。整车适配层面,X7 Ultra采用Armv9车规级CPU,激光雷达处理带宽最高2000万点/秒,满足ISO 26262 ASIL-B功能安全要求,内置MCU通过ASIL-D认证;此前X7芯片累计出货已超过20万颗。
算力之外,双方把评价标准也改了。过去谈智驾芯片习惯看“每瓦算力”这类纸面指标,新的合作方向要求考察完整驾驶任务中的响应速度、系统功耗与持续运行稳定性;在系统层面协同优化模型、芯片与整车散热,按路况复杂度分配算力,减少不必要的能耗,让同样的算力在不同价位车型上稳定发挥。
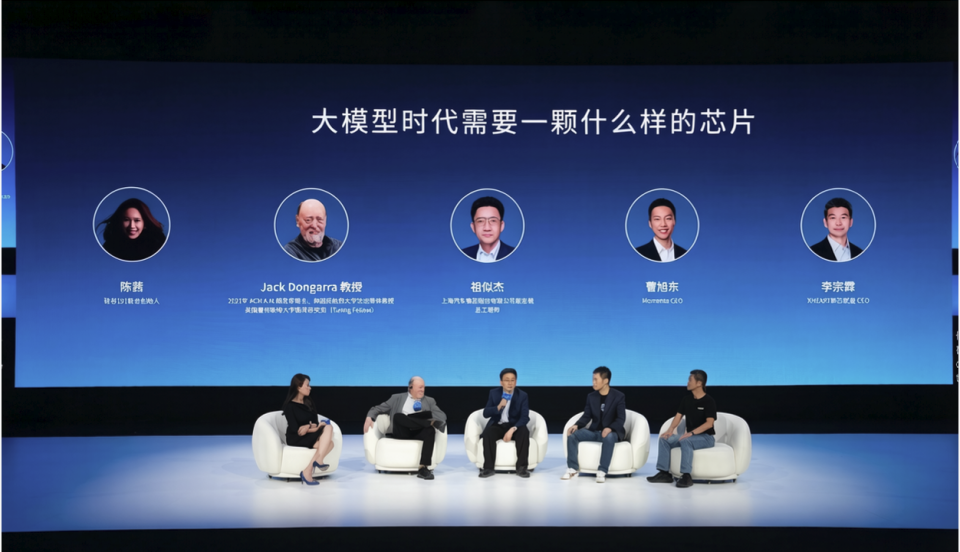
产品落地层面,双方提出“同源架构、多档位布局、全场景覆盖”的策略,以同一套底层架构衍生不同性能档位的芯片产品,适配从轻量级到高复杂度的各类智驾模型,覆盖不同价位车型,并为L3、L4车型的规模化装配留出扩展空间。先进工艺则要与量产条件配合,上汽将结合芯片设计、封装、散热、车规可靠性与制造成本评估技术方案,避免只追求参数而抬高整车成本。
从行业角度看,这次合作的看点不在单颗芯片的算力数字,而在整车厂与芯片公司的关系变化:从选型采购转向共同定义,把整车应用中的反馈持续输入模型演进与芯片设计,缩短适配周期。真正决定成败的仍是量产车型的实际上车表现——端到端大模型、VLA与世界模型在车端的推理时延、功耗和长期可靠性,能否在十几万元级车型上同样成立,还需要后续产品验证。